Porto, 11 de novembro de 2026
- Desenvolvido por investigadores ligados à XPENG, à Universidade de Pequim, à Universidade de Hong Kong e a outras instituições académicas, o GroundingPI introduz uma nova abordagem aos modelos fundacionais de Physical AI, centrada na perceção visual.
- O modelo, com 4 mil milhões de parâmetros, alcançou uma pontuação média de 73,68 em 34 benchmarks de perceção, superando o GPT-6 Astra (71,54) na avaliação realizada pela equipa de investigação.
- Os resultados de simulação demonstram melhorias no desempenho da manipulação robótica e na eficiência da utilização de dados de treino. O código de investigação e os pesos do modelo estão disponíveis publicamente para a comunidade de investigação em Inteligência Artificial.
A XPENG, líder global em veículos elétricos inteligentes e referência na área da Physical AI (Inteligência Artificial Física), apoiou o desenvolvimento do GroundingPI, um modelo fundacional de perceção visual de código aberto, criado por investigadores ligados à XPENG, à Universidade de Pequim, à Universidade de Hong Kong e a outras instituições académicas.
Esta investigação explora uma nova abordagem à inteligência incorporada (embodied intelligence), centrando-se numa capacidade fundamental: permitir que os sistemas de Inteligência Artificial identifiquem objetos com precisão e compreendam a sua localização espacial no mundo físico. Com aproximadamente 4 mil milhões de parâmetros, o GroundingPI alcançou a pontuação global mais elevada entre os 44 modelos de referência avaliados, em 34 benchmarks de perceção que abrangem 11 categorias de capacidades.
O artigo científico, os pesos do modelo e o código de suporte foram disponibilizados publicamente, permitindo que investigadores e programadores aprofundem a exploração de abordagens à Physical AI centradas na perceção visual.
À medida que a Inteligência Artificial ultrapassa progressivamente os ambientes digitais e se estende a aplicações físicas, como a robótica e a condução autónoma, torna-se essencial compreender com precisão o ambiente envolvente.
Embora os modelos fundacionais de utilização geral tenham demonstrado capacidades significativas ao nível da compreensão da linguagem, do raciocínio e do planeamento, a inteligência aplicada ao mundo físico exige uma perceção visual mais precisa. Os sistemas de IA não devem apenas reconhecer objetos, mas também identificar a sua localização exata e as relações espaciais entre eles, de forma a permitir a interação com o mundo real.
O GroundingPI adota uma abordagem centrada na perceção para responder a este desafio. Em vez de recorrer a etiquetas de ações robóticas durante o treino do modelo de perceção, a investigação concentra-se no desenvolvimento de capacidades fundamentais de compreensão visual, que podem servir de base a sistemas de aprendizagem de ações numa fase posterior.
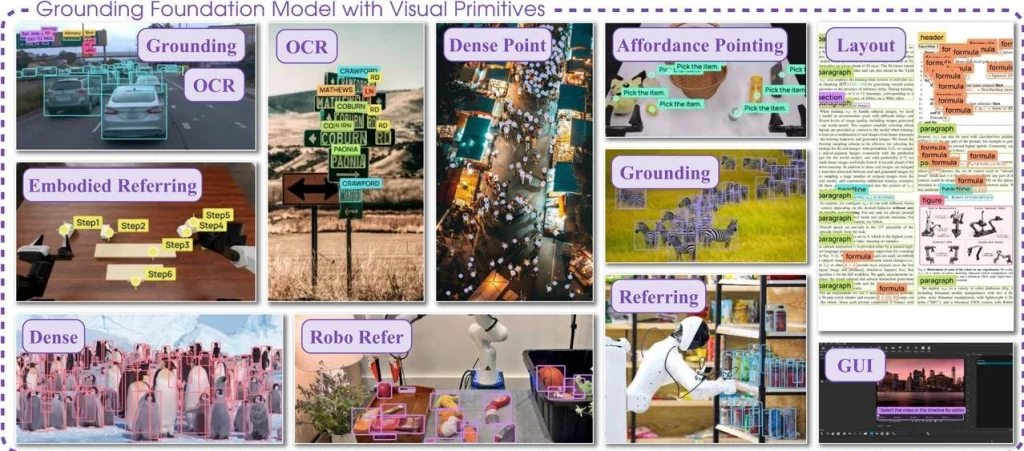
Por exemplo, perante a instrução “identificar a pega da chávena que está à direita”, um sistema de IA tem de localizar não só a chávena correta, mas também a posição exata da respetiva pega. O GroundingPI foi concebido para representar este tipo de informação através de coordenadas espaciais, incluindo pontos e caixas delimitadoras (bounding boxes).
O modelo foi treinado em 11 categorias de capacidades de perceção, incluindo deteção de objetos, localização detalhada de objetos, identificação de elementos visuais com base em descrições textuais, reconhecimento ótico de caracteres (OCR), compreensão da estrutura de documentos, reconhecimento de elementos de interfaces de utilizador e localização espacial aplicada à robótica.
Ao reforçar estas capacidades fundamentais, a investigação explora de que forma os modelos especializados em perceção podem proporcionar uma base visual mais eficaz para sistemas de IA incorporada.
Desempenho de destaque em 34 benchmarks de perceção
Nas avaliações realizadas pela equipa de investigação, o GroundingPI foi comparado com 44 modelos de referência, através de 34 benchmarks públicos de perceção, distribuídos por 11 categorias de capacidades.
Utilizando uma pontuação global de avaliação, com ponderação igual para todas as categorias, o GroundingPI alcançou 73,68 pontos, face aos 71,54 pontos obtidos pelo GPT-6 Astra.
Os resultados demonstram o potencial dos modelos especializados em perceção para superar modelos de utilização geral de maior dimensão em tarefas específicas de identificação e localização visual. Esta comparação diz respeito exclusivamente aos benchmarks de perceção avaliados e não representa uma avaliação mais abrangente da inteligência ou das capacidades de raciocínio geral dos sistemas de IA.
O desempenho do GroundingPI revelou-se particularmente relevante em tarefas que exigem a localização precisa de objetos, incluindo cenários visuais complexos, com numerosos objetos ou elementos de pequenas dimensões.
Estas conclusões sugerem que o pré-treino direcionado para capacidades específicas de perceção pode constituir uma base valiosa para a investigação futura em Physical AI, complementando as capacidades mais abrangentes de raciocínio e planeamento dos modelos fundacionais de utilização geral.
Maior eficiência na aprendizagem robótica e capacidade de adaptação a diferentes ambientes
Para além dos benchmarks de perceção, a equipa de investigação avaliou o GroundingPI enquanto base visual para tarefas posteriores de manipulação robótica e condução autónoma.
Os resultados evidenciam duas potenciais vantagens para o desenvolvimento da inteligência incorporada.
Maior eficiência na utilização de dados de treino
Os sistemas robóticos necessitam frequentemente de um elevado número de demonstrações humanas para aprender novas tarefas de manipulação, o que representa um desafio significativo ao nível da recolha de dados e do treino.
Nas experiências de simulação RoboCasa-GR1, os sistemas de aprendizagem robótica que utilizaram o GroundingPI como base visual alcançaram taxas de sucesso superiores recorrendo a apenas 50% dos dados de demonstração disponíveis, quando comparados com os modelos de referência avaliados, treinados com 75% desses mesmos dados.
Este resultado sugere que capacidades fundamentais de perceção mais avançadas poderão reduzir a quantidade de dados de treino de ações necessária para determinadas tarefas robóticas, contribuindo potencialmente para uma maior eficiência no desenvolvimento futuro da Physical AI.
Maior capacidade de adaptação a diferentes ambientes
Outro dos principais desafios da robótica é a generalização, ou seja, a capacidade de executar uma tarefa aprendida mesmo quando os objetos, os cenários ou as condições ambientais sofrem alterações.
Nas avaliações de simulação RoboTwin 2.0, o GroundingPI demonstrou um desempenho superior ao dos modelos de base visuais convencionais avaliados, em quatro cenários de distribuição diferente dos dados de treino (out-of-distribution), evidenciando uma maior capacidade de adaptação a ambientes desconhecidos.
A equipa de investigação avaliou também o seu potencial para a perceção aplicada à condução autónoma, utilizando o conjunto de dados nuScenes. Quando integrado como base visual, o GroundingPI alcançou um erro médio de previsão de trajetória em circuito aberto de 0,296 metros, na avaliação apresentada.
Em conjunto, estes resultados experimentais evidenciam o potencial dos modelos fundacionais centrados na perceção para apoiar o desenvolvimento de sistemas de inteligência incorporada mais adaptáveis e eficientes na utilização de dados.
Promover a investigação aberta no domínio da Physical AI
O GroundingPI explora uma linha de investigação em que as capacidades especializadas de perceção visual complementam níveis superiores de raciocínio e planeamento, em vez de depender exclusivamente de modelos de utilização geral para todos os componentes de um sistema de inteligência incorporada.
As conclusões contribuem para aprofundar o conhecimento sobre a forma como o pré-treino orientado para a perceção pode apoiar a investigação futura em áreas como a manipulação robótica, a condução autónoma e outras aplicações que exigem uma interação precisa com o mundo físico.
Com o objetivo de incentivar a exploração e a colaboração nesta área, a equipa de investigação disponibilizou publicamente o artigo científico, os pesos do modelo e o respetivo código de suporte do GroundingPI, sujeitos aos termos de licenciamento aplicáveis, incluindo os de código aberto e de terceiros.
Recursos de Investigação
Website do Projeto: https://groundingpi.github.io/
Artigo Científico: https://arxiv.org/abs/2609.39601
Código-Fonte: https://github.com/groundingpi/GroundingPI
Pesos do Modelo: https://huggingface.co/GroundingPI/GroundingPI
Nota: A investigação encontra-se ainda numa fase exploratória. Os resultados obtidos nas tarefas subsequentes baseiam-se em simulações e avaliações offline, não demonstrando, por si só, que a tecnologia esteja preparada para uma implementação comercial em condições reais.
Este projeto constitui um contributo de investigação académica apoiado pela XPENG e pelos seus parceiros de investigação. Os resultados não representam um anúncio de integração desta tecnologia nos produtos da XPENG, nem constituem um compromisso relativamente à sua futura implementação.